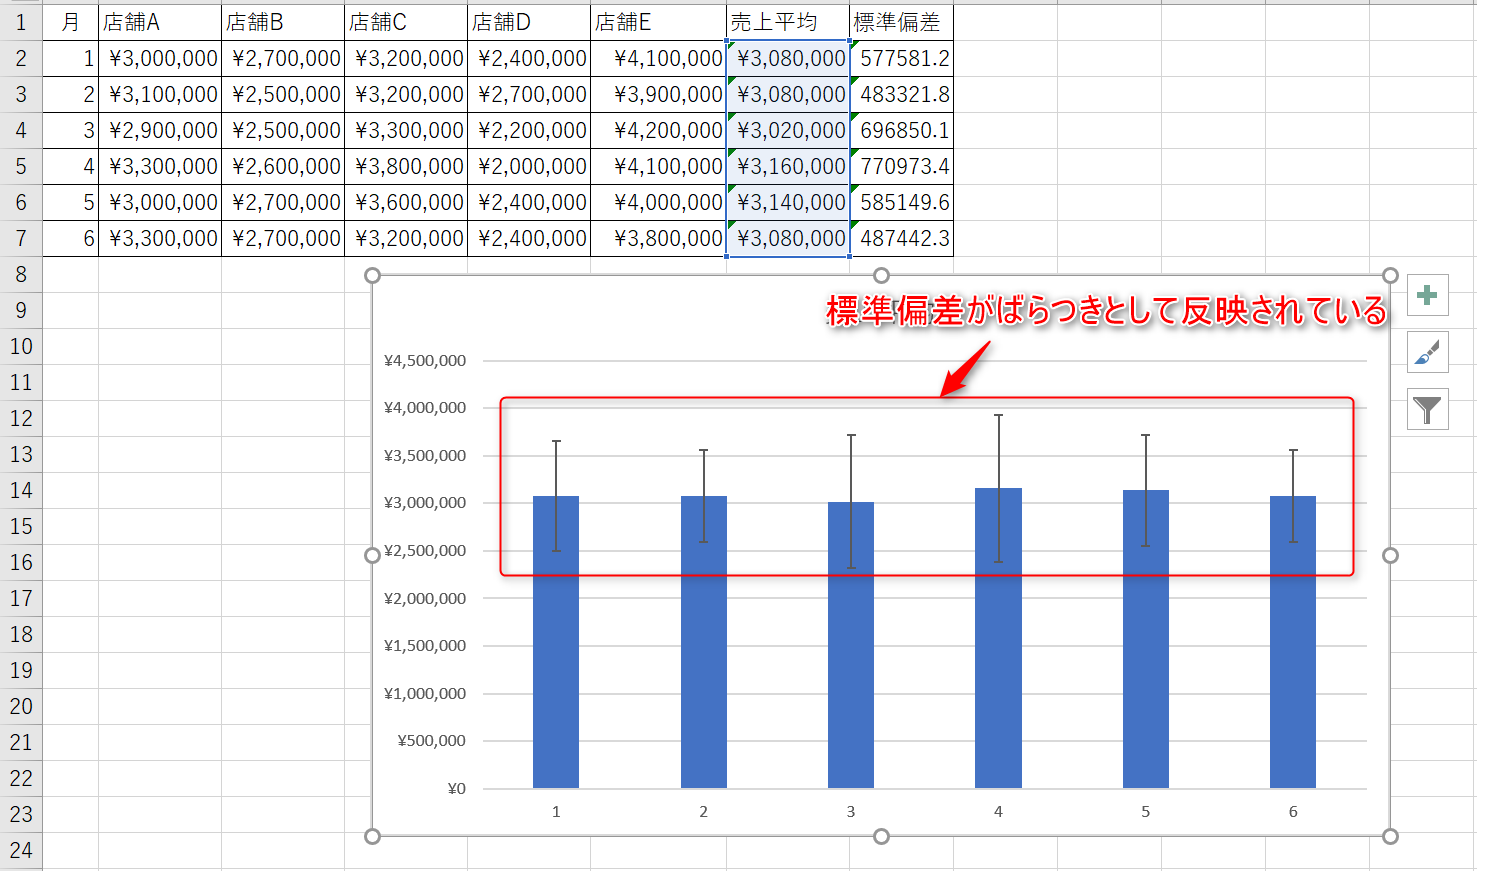
Excelで標準偏差を計算する際、最大の分かれ道となるのがSTDEV.PとSTDEV.Sの違いです。両者は一見すると似たような数値を返しますが、計算式の分母が異なるため、特にデータ件数が少ない場合には計算結果に明らかな差が生じます。
この2つの関数は、統計学における「母集団」と「標本」の概念に直結しています。それぞれの特性を正しく把握することが、分析ミスを防ぐ防波堤となります。
母集団と標本分散の決定的な違いは、手元にあるデータそのものが分析の「最終的な対象(全数)」なのか、それとも「巨大な全体から抜き出した一部(サンプル)」なのかという点に集約されます。
- STDEV.P(母集団の標準偏差 / Population):手元にあるデータが調査対象のすべてである場合に使用します。分散を計算する際、偏差の平方和をデータ数「n」で割ります。社内の全従業員の給与データや、学校の1クラス全員のテスト結果などが該当します。
- STDEV.S(標本の標準偏差 / Sample):手元のデータが全体から抽出されたサンプルであり、背後にある未知の母集団の散らばりを推測したい場合に使用します。分散の計算では、自由度を考慮して「n - 1」(不偏分散)で割ります。顧客満足度アンケートの無作為抽出サンプルや、製造ラインから抜き取った検査ロットなどが該当します。
サンプルサイズが極めて大きいビッグデータであれば、分母が「n」でも「n - 1」でも計算結果の差はごくわずかです。しかし、実務でよくあるサンプル数10件や20件の小規模データでは、nで割るかn-1で割るかによって約5%〜10%以上の数値差が生じます。これを取り違えると、品質管理基準の合否判定やリスク評価に重大な狂いをもたらす要因になります。

